最近在試一件事:本機用小模型,把文件塞進 RAG,看「小馬力」能不能把知識問答駕馭起來。 中間走了一段 Ollama+AnythingLLM,結論先講:
小模型練手可以,但要當「正常好用的日常工具」還差一截——幻覺太多。
後來換 MCP 串 ERP,讓 Agent 先釐清要查什麼,不熟悉畫面時反而查得快。
第一段:Ollama × AnythingLLM 練 RAG
工具組合很直觀:
- Ollama:本機拉模型、開 API
- AnythingLLM:文件工作區、向量、聊天介面,方便接 Ollama
為什麼還要練小模型 RAG?
- 資料盡量留本機
- 想搞清楚:檢索/切段/提示詞是不是比換大模型更關鍵
- 機器資源有限時,小模型+RAG 到底夠不夠
RAG 超短版
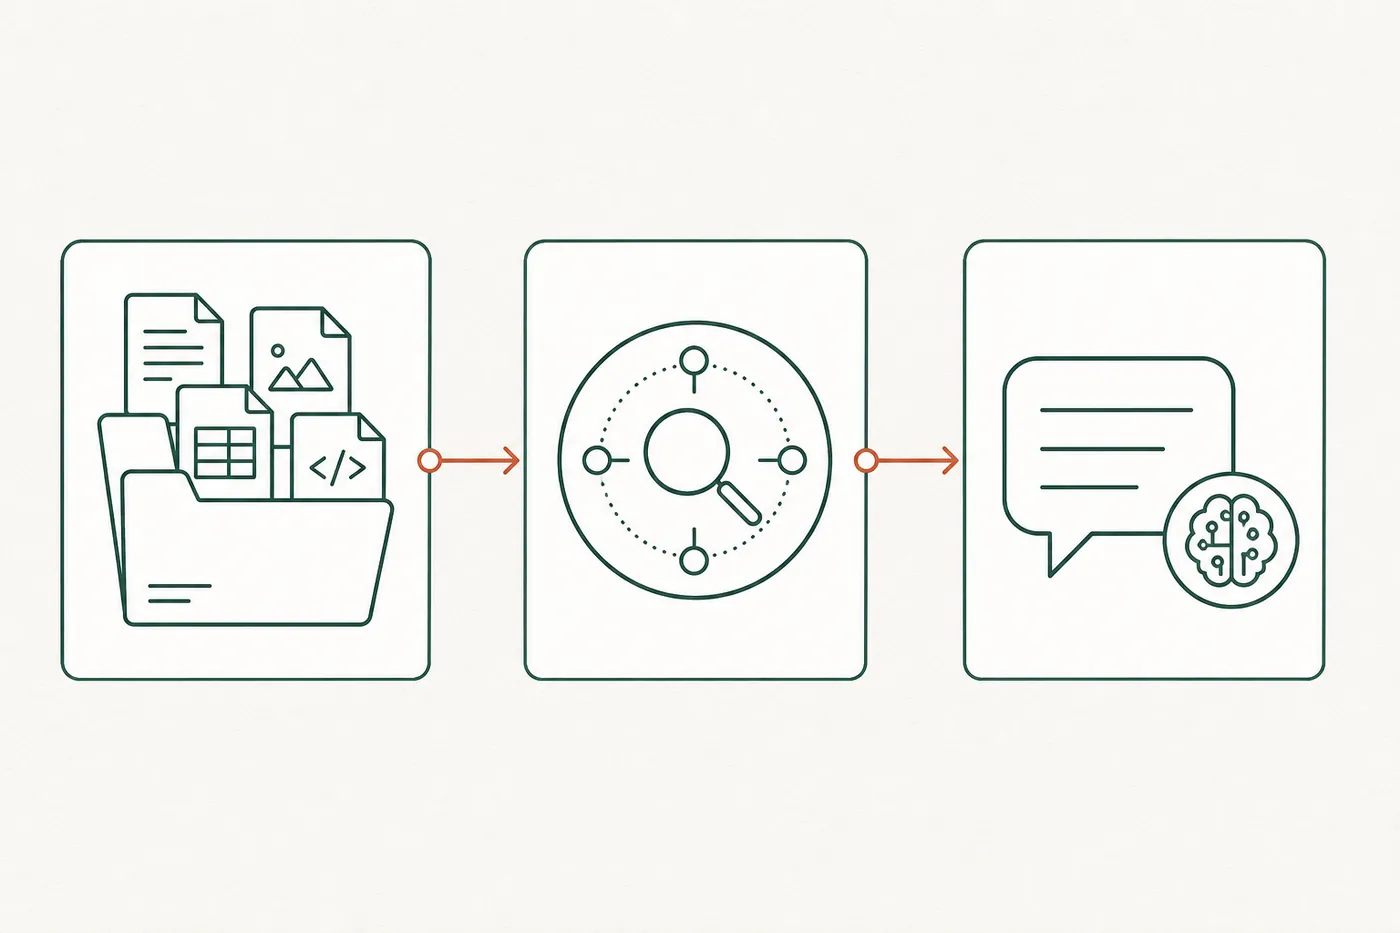
- ingest:文件切段、做成向量
- retrieve:依問題找相關段落
- generate:段落+問題丟給模型回答
AnythingLLM 的好處是工作區/文件/聊天一次收好,適合當練習場。
練習時怎麼走
- 先讓 Ollama 能穩定對話,再丟文件
- 文件從「自己熟悉的筆記」開始,才分得出來是檢索偏了還是模型亂講
- 常見爆點:答非所問、自信講錯、記憶體不夠
卡住的點:幻覺,難進「正常使用」
實測一陣子後,最大感受是:
模型太小 → 很容易幻覺(胡說八道),很難達到日常可放心用的範圍。
具體一點:
- 文件明明沒寫,它會補故事補得很完整
- 檢索到半對的段落,生成階段會「腦補」接成整段錯答案
- 同樣問題問兩次,答案飄,難以當查詢工具依賴
RAG 可以把「找資料」做起來,但小模型在 依證據生成 這步不夠穩。當成認識 RAG 流程、調 chunk 很好;當成公司/日常「問了就能信」的介面,目前我不夠敢用。
到這裡,路線就該轉了:不要只讓模型「背文件」,而是讓它「會去查系統」。
第二段:改用 MCP 串 ERP,跟 Agent 對話查資料
後續我改成 MCP(Model Context Protocol) 這條路:把能力做成工具,接上 ERP,讓 Agent 在對話裡決定要不要查、查什麼。
使用節奏不太一樣
熟悉的系統 UI,本來就快:選單點下去、篩條件、看報表。
但在 不熟悉的狀況(某個畫面在哪、哪個報表欄位叫什麼),跟人(或 Agent)對話反而省事:
- 先用自然語言說「我想看什麼」
- Agent 會反問/確認:是不是要查某類資料、哪個條件、哪個範圍
- 確認後再呼叫對應工具去 ERP 撈
- 很快對到你要的結果
重點不是讓模型「猜 ERP 裡有什麼」,而是:
對話釐清意圖 → 明確查詢 → 工具回真實資料。
這樣幻覺空間會小很多——因為答案主體來自 ERP 回傳,不是小模型憑空寫。
什麼時候用 Agent,什麼時候點 UI?
| 情境 | 我的選擇 |
|---|---|
| 不熟選單/報表在哪 | 問 Agent:讓它反饋「要不要查哪個資料」再查 |
| 已經很熟的路徑 | 直接開原有 UI 點就好,更快、也更精準 |
Agent 不是要取代 ERP 畫面,比較像「陌生地圖上的嚮導」;熟路還是自己開比較爽。
跟純 RAG 差在哪
| 文件 RAG(小模型) | MCP 串 ERP | |
|---|---|---|
| 答案來源 | 切好的文件片段+模型生成 | 系統查詢結果為主 |
| 失敗模式 | 幻覺、編故事 | 查錯條件、權限、或工具沒接好 |
| 適合 | 練流程、靜態知識 | 動態業務資料、不熟畫面時的導航式查詢 |
目前總結
- Ollama+AnythingLLM+小模型:適合認識 RAG,但幻覺偏多,我暫時不當「正常好用」的主工具。
- MCP 接 ERP+Agent:對話先對齊要查什麼,再打真實資料;不熟系統時特別有感。
- 熟的人繼續用 UI;Agent 是補「不認得路」的那段,不是硬取代點選。
之後若整理出比較乾淨的 MCP 工具切分(哪些查詢開放、怎麼做二次確認),再另寫一篇實作細節。這篇先把路線轉彎記下來:從「背文件」轉成「會查系統」。